会社案内資料



UX / UI のデザインに強いWebシステムの開発と、BtoB Webマーケを支援するWeb制作を提供するN’s Creates (エヌズクリエイツ) 株式会社の西田です。
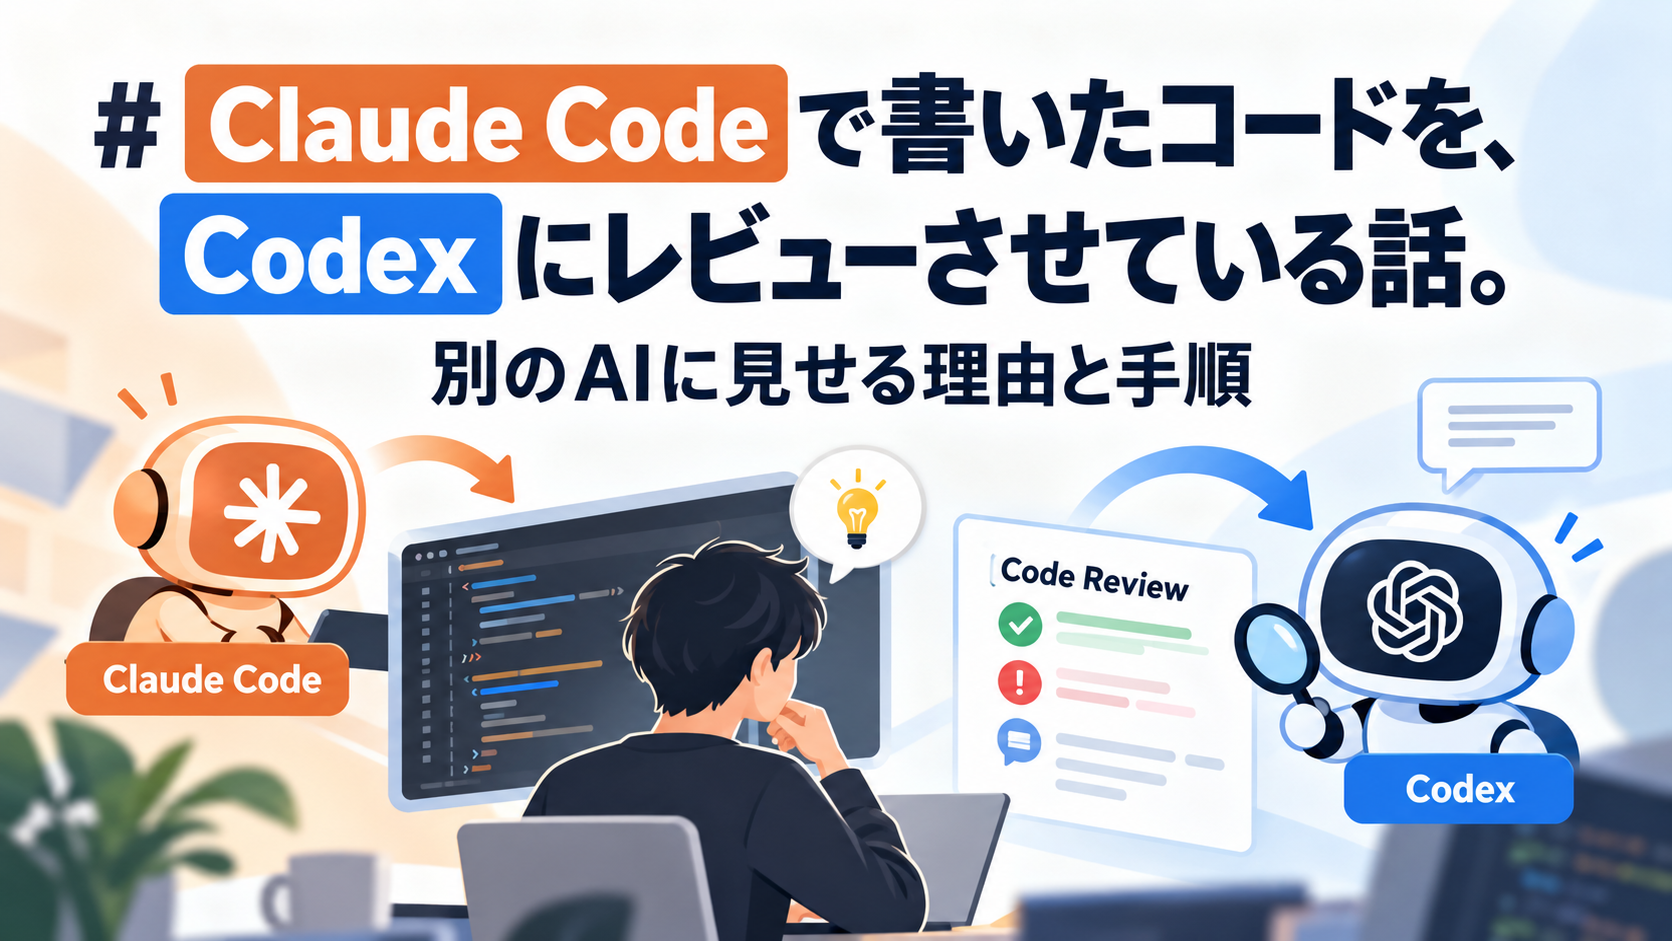
前回の記事で、「Claude Codeで実装したコードをCodexにレビューさせている」という話に触れました。ただ、「具体的にどうやって渡しているのか」までは書けていなかったので、今回はその中身を書きます。
この記事で扱うのは、次の3つです。
・なぜ同じAIにレビューさせるだけでは足りないのか
・Codexへの具体的な渡し方(公式プラグイン)
・返ってきた指摘を、どう扱っているか
※ コマンドやオプションは執筆時点のものです。更新が速いツールなので、試すときは公式のREADMEもあわせて確認してください。
同じAIの自己レビューは、なぜ甘くなるのか
きっかけは、Claude Codeに実装させたコードを同じセッションのまま見直させたら「問題ありません」と返ってきたのに、Codexに渡すと外部API失敗時のエラーハンドリング漏れを指摘された、という出来事でした(詳しくは前回の記事に書いています)。
振り返ると、見落とした理由は2つあったと考えています。
1つ目:書いたときの前提を共有している
同じセッションのAIは、「何を作ろうとしていたか」「どこに力を入れて作ったか」という文脈をそのまま持っています。このときは正常系を作ることに意識が向いていて、見直しもその延長で正常系をなぞるだけになっていました。書いたときと同じ視点で見直すので、書いたときに見えていなかったものは、見直しても見えません。自分で書いた文章の誤字に、自分ではなかなか気づけないのと同じです。
2つ目:同じモデルは、同じところで見落としやすい
1つ目だけなら、新しいセッションのClaude Codeにレビューさせれば解決しそうです。それも有効な方法だと思います。
正直に言うと、このときはセッションもモデルも両方変えていたので、どちらが効いたのかは切り分けられていません。それでも別のモデルに頼んでいるのは、自分の経験では、同じモデルだとセッションを分けても似た傾向の指摘になりやすいと感じているからです。人間のレビューでも、同じ人が日を改めて見直すより、別の人に見てもらうほうが違う指摘が出てきますよね。
なので、別のモデルを使う意味は単純な性能の差だけではなく、「見落とし方が違うこと」にもあると考えています。
Codexへの渡し方:公式プラグインで、Claude Codeの中から呼ぶ
いちばん手軽なのは、OpenAIが公開しているClaude Code向けのCodexプラグイン(openai/codex-plugin-cc)です。Claude Codeの中からそのままCodexを呼び出せます。
導入はClaude Code上で次の3つを実行するだけです。前提として、Codex CLIのインストールと、ChatGPTアカウントかOpenAIのAPIキーが必要です。
/plugin marketplace add openai/codex-plugin-cc
/plugin install codex@openai-codex
/codex:setup日常的に使っているのは、/codex:review と /codex:adversarial-review の2つです。役割はこう分けています。
・/codex:review:変更内容をそのまま見せて、バグを探してもらう。観点は指定できない
・/codex:adversarial-review:仕様や「ここが怖い」という観点を渡して、実装の前提や設計判断を疑ってもらう
まず /codex:review は、変更内容をそのままレビューさせる基本のコマンドです。小さな変更なら、これだけで済ませることも多いです。
# 未コミットの変更を通常レビュー(読み取り専用)
/codex:review

# mainブランチとの差分をレビュー
/codex:review --base main
もうひとつの /codex:adversarial-review は、フラグの後ろに「何を疑ってほしいか」を書けます。仕様と照らしてほしいときや、認証まわり・データ移行のように「表面のバグより隠れた前提のほうが怖い」変更では、こちらを使います。
/codex:adversarial-review --base main 外部API失敗時のリトライとエラーハンドリングの設計が妥当か疑ってくださいプラグインを使わずに、Codex CLIの codex exec review をターミナルから直接呼ぶ方法もあります。ただ、出力の取り出し方に少しクセがあります。気になる方は tdkskさんのZennの記事 が詳しいです。自分はClaude Codeの中で完結するプラグインのほうが手軽なので、こちらを使っています。
adversarial-reviewに何を渡すか
/codex:adversarial-review を使うときに効いてくるのは、「何を一緒に渡すか」です。
差分だけでなく、仕様も渡す
差分だけでは、そのプロジェクト固有の仕様や、期待している振る舞いまでは判断しにくくなります。「仕様ではこう書いてあるのに、実装がそうなっていない」という種類の漏れは、仕様を渡さないと見つけるのが難しいんです。
そこで、仕様の要点を観点として書いて渡します。
/codex:adversarial-review --base main 仕様:外部APIが失敗したら3回までリトライし、それでも失敗したら管理者に通知する。この仕様どおりに実装されているか、漏れている条件がないか確認してください実装に合わせて書かれ、仕様を何も検証していないテスト(前回の記事では「都合の良いテスト」と呼びました)も、仕様と突き合わせて初めて気づける問題です。
観点を絞る
adversarial-review は名前のとおり疑う方向に寄るので、観点が広いと指摘が大量に返ってきて、本当に大事な指摘が埋もれます。その変更でいちばん怖いところを2〜3個に絞って書くようにしています。
書き込み権限を渡さない
レビュー役には読み取り専用で動いてもらいます。プラグインのレビュー系コマンドは最初から読み取り専用なので、この点でも安心して使えます。「見る役」と「直す役」を分けておかないと、誰が何を変えたのか追えなくなるからです。
返ってきた指摘をどう扱うか
ここがいちばん大事なところだと思っています。Codexの指摘も、鵜呑みにはしません。
実際、的外れな指摘も返ってきます。プロジェクト固有の事情を知らないので、「この処理は不要では」と言われたものが、実は別の仕様上の理由で必要だった、ということもあります。
Claude Codeには「判断」ではなく「根拠集め」を頼む
指摘の検討にはClaude Codeも使いますが、実装したセッションには戻しません。1つ目の理由で書いたとおり、実装時の前提を引き継いだままだと、同じ視点でしか指摘を見られないからです。新しいセッションを立ち上げて、指摘と該当コードだけを渡します。
そして、「この指摘は妥当か」とは聞きません。2つ目の理由で書いたように、Claudeにも見落としやすい傾向があるので、判断まで任せるとその傾向がそのまま結論に出てしまいます。頼むのは根拠を集めることだけです。
・指摘が正しいなら起きるはずの問題を、再現するテストを書く
・指摘が不要だと言えるなら、その根拠になる仕様やコードの該当箇所を示す
意見を聞くと、AIはもっともらしい理由をいくらでも作れてしまいます。根拠なら、人間が見て確かめられます。
再現テストも、そのまま信じない
ここで気をつけているのが、AIに書かせた再現テスト自体が「都合の良いテスト」になる可能性です。テストが失敗したからといって、指摘が正しいとは限りません。テストの期待値そのものが間違っていることもあるからです。
なので、再現テストは「期待値が仕様どおりか」を自分で確認してから使います。そのうえで、テスト・仕様・実装を突き合わせて、直すかどうかを自分で決めます。AIの根拠がはっきりしない箇所こそ、人間が時間を使うべき場所だと考えています。
自動化しすぎない
公式プラグインには、Claude Codeが作業を終えるたびに自動でCodexレビューを走らせる「レビューゲート」という機能もあります。ただ、READMEには、ClaudeとCodexのやり取りが長時間ループして使用量を一気に消費するおそれがある、という趣旨の注意書きがあり、初期状態では無効になっています。
自分はレビューゲートは使わず、「ここでレビューに出す」というタイミングを自分で決めて手動で呼んでいます。いつ別の目を入れるかを判断するのも、人間の仕事の一部だと思っているからです。
おわりに
まとめると、自分がやっているのは次の3つです。
1. 書いたAIとは別のAIに、文脈を共有しない状態でレビューさせる
2. 仕様や観点を渡したいときは adversarial-review を使い、「いちばん怖いところ」に絞って渡す
3. 指摘は鵜呑みにせず、別セッションのAIには根拠だけを集めさせて、判断は人間がする
「別の人に見てもらう」という考え方は、人間同士のコードレビューと同じです。ただ、AIはもっともらしい根拠をいくらでも作れる、という点が人間とは違います。だから意見ではなく確かめられる根拠を求め、判断は自分でします。AIを2つ使うのは、AIが書いたコードでもレビューに出す以上は自分のコードとして責任を持つ、そのための材料を増やすためです。
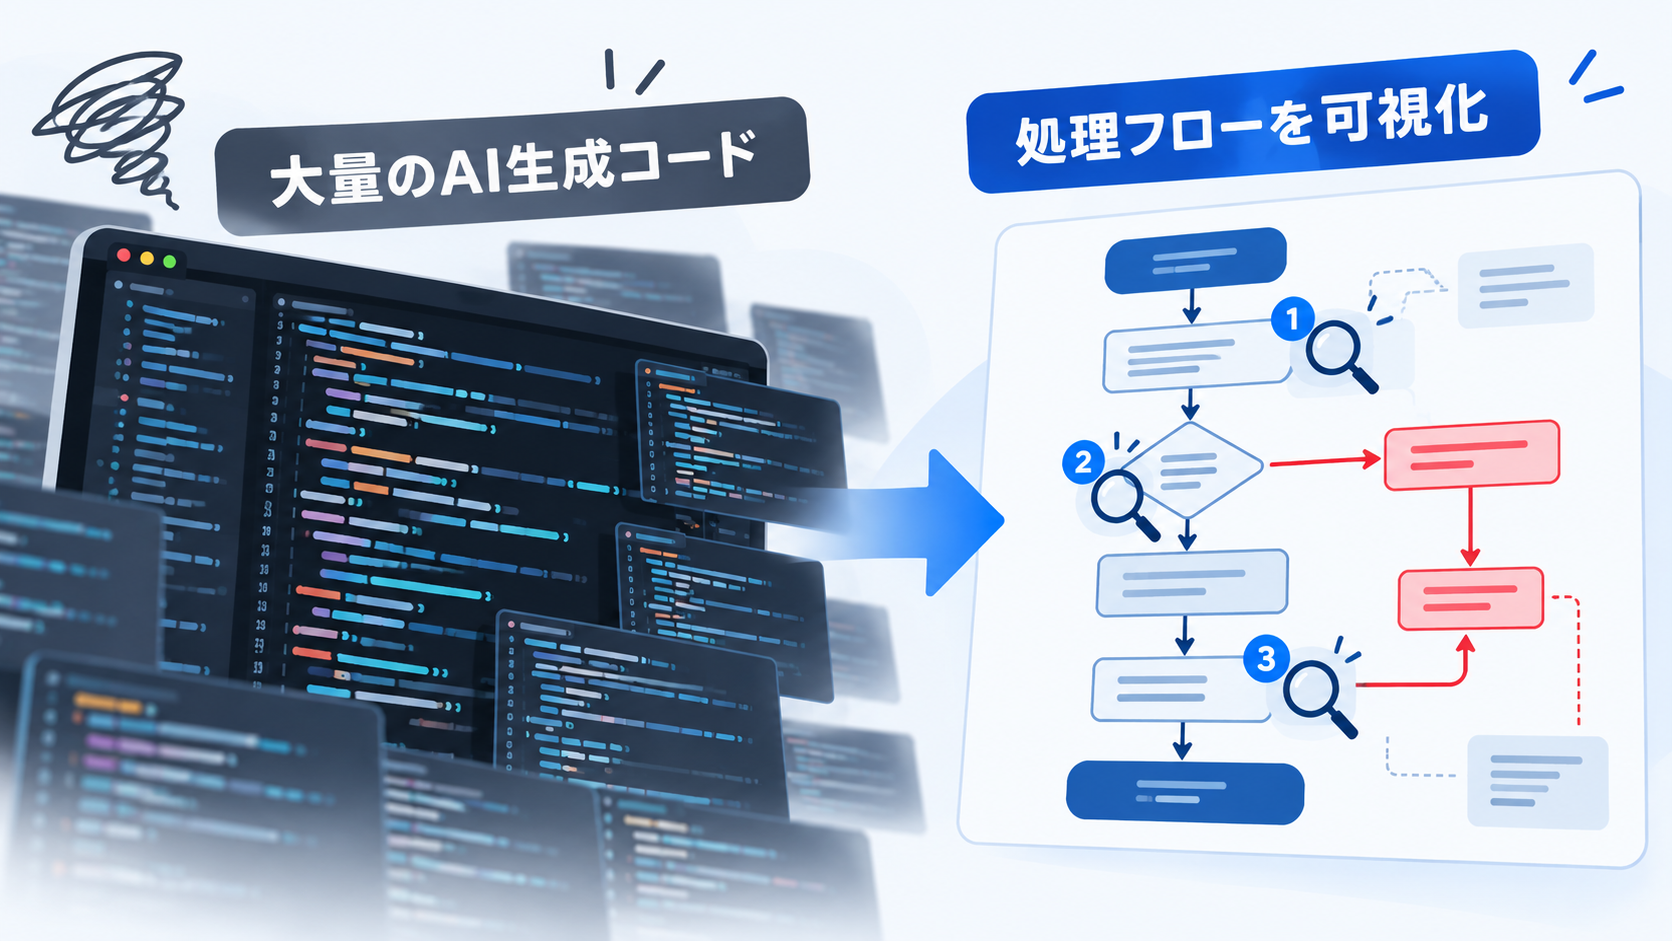
もうひとつ、レビューに出す前に、Claude Codeに処理のフローをHTMLで図解させて確認する、ということもよくやっています。こちらは次回の記事で書く予定です。
N’s Createsでは、こうした「この組み合わせが良かった」という知見をチームで日常的に共有しています。こういう開発の進め方に興味があれば、採用情報ものぞいてみてください。
参考
・openai/codex-plugin-cc(GitHub)
・Claude Code で Codex CLI の review コマンドを呼び出す方法(Zenn / tdksk)